107.750 citas agendadas y cero memoria: cómo le enseñé a soñar a un producto de diez años
Cada noche a las 2:30 mi sistema de citas por WhatsApp consolida lo que aprendió y olvida a propósito. Los cuatro pasos para darle memoria a tu producto.
Dos de la mañana en Bogotá
Todas las clínicas que corren sobre Appcitas están a oscuras ahora mismo. Las recepcionistas duermen. Los pacientes duermen.
El sistema no.
A las 2:00 revisa lo que quedó del día: conversaciones de WhatsApp que llevan más de dos horas en silencio, sesiones web abandonadas hace días. Las cierra, anota qué pasó en cada una y deja en cola la tarea de la noche. A las 2:30 se despierta un segundo proceso y el sistema empieza a soñar. Convierte los resúmenes del día en vectores. Los lunes destila una semana de conversaciones en patrones por clínica. Y el primero de cada mes hace la cosa más rara que le he pedido a un software.
Olvida. A propósito. Con calendario.
Esto lo lancé en julio dentro de un producto que opero desde 2015. El núcleo salió a producción en un solo día, sobre infraestructura aburrida, por centavos cada noche. Este artículo es el cómo, porque el cómo es la parte que nadie muestra. Y porque si tienes una clínica, una cadena de consultorios o un SaaS con años de conversaciones por WhatsApp guardadas, la excusa que tienes para no hacer esto está a punto de adelgazar.
El ancla en la que probablemente estás
Si operas un producto, ya sabes que “debería usar IA”. Todo el mundo te lo ha dicho. Y la única idea concreta que alguien propone es un chat en la esquina, que es la forma en que un producto le avisa al mundo que se quedó sin ideas.
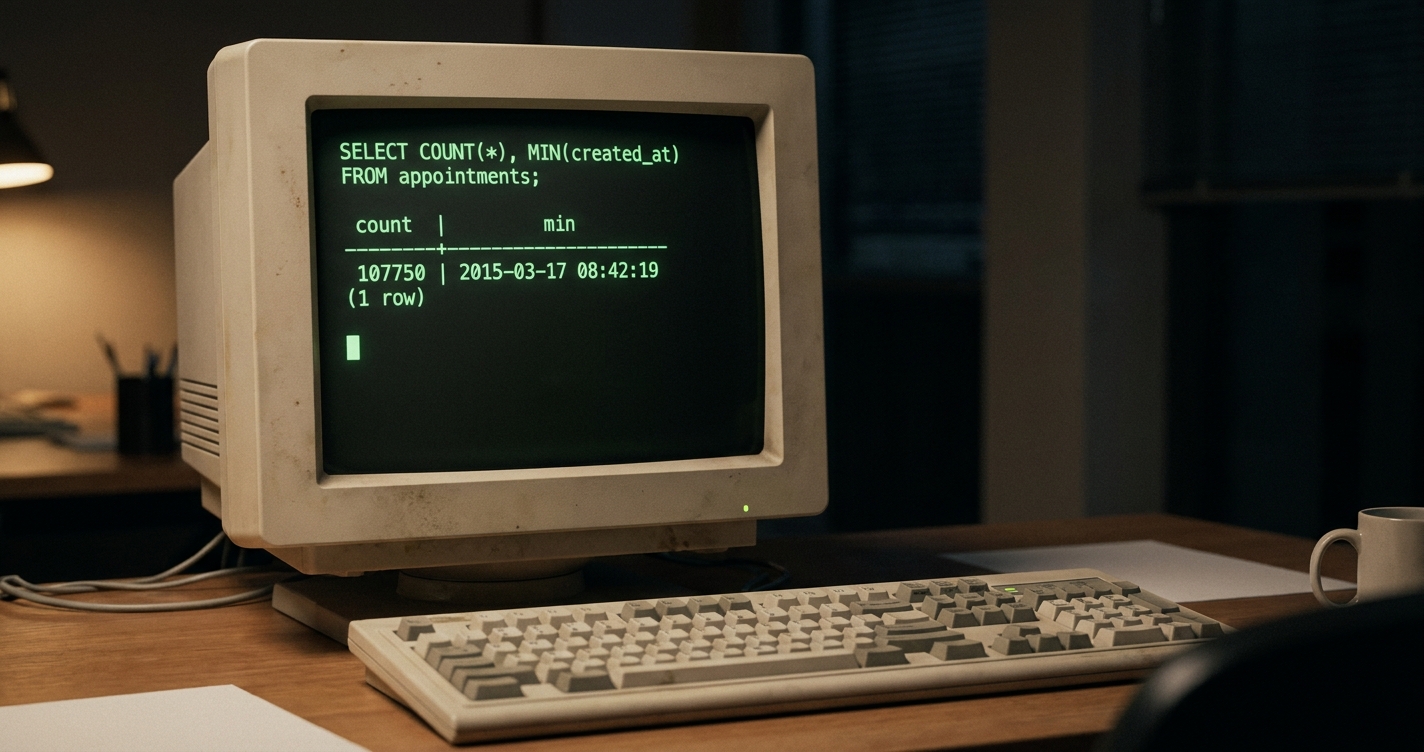
Yo estaba ahí también, sentado sobre 107.750 citas agendadas y nueve años de conversaciones que mi sistema nunca había vuelto a leer. Escribir esa frase da vergüenza. Lo que debería preocuparte es que probablemente describe tu producto también, y no da ninguna vergüenza.
La salida del ancla es entender que esto nunca fue un problema de IA. Es un problema de memoria, y la memoria es una capa que se construye por pasos. Cuatro, en el orden en que los volvería a hacer, con los números reales de mi sistema en producción para que calibres el tuyo.
Paso 1: decidir qué es un recuerdo
No es “guardar más datos”. Ya guardas todo. La pregunta es qué unidad de experiencia vale la pena recordar como una sola cosa.
En Appcitas la respuesta fue la conversación cerrada. Cuando un hilo de WhatsApp se queda en silencio, el sistema escribe un episodio: un resumen de dos frases, un resultado (agendó, canceló, abandonó), el sentimiento del paciente y las intenciones que detectó. Una llamada al modelo por conversación, temperatura 0, tope de 700 tokens de salida. Barato y aburrido por diseño.
En tu producto la unidad es lo que sea que cierra: el pedido completado, el ticket resuelto, la cuenta que se fue, el carrito abandonado. Si tu dominio tiene un momento natural donde una historia termina, esa historia es tu episodio. Escríbela en ese momento, porque es cuando el contexto todavía existe.
Paso 2: destilar hechos, no logs
Un episodio dice qué pasó. Un recuerdo dice qué sigue siendo cierto después. Son tablas distintas.
Mis filas de memoria de paciente son cinco columnas que sirven en cualquier dominio: un tipo, una clave de un vocabulario controlado, un valor, un puntaje de confianza y un contador de menciones. “Prefiere sábados por la mañana, confianza 0,7, mencionado 3 veces.” La extracción saca como máximo cinco de estas por conversación, y cada valor nace con la confianza acotada entre 0,3 y 0,9.
El vocabulario controlado es la parte que defendería en una pelea. Deja que el modelo invente claves y terminas con cuarenta formas de escribir “horario preferido” que nunca se refuerzan entre sí. Restringe las claves y la repetición se vuelve señal: cada vez que un paciente vuelve a mencionar el mismo hecho, la confianza sube 0,05 y el contador avanza. El sistema no cree cosas porque un modelo las dijo una vez. Cree lo que los pacientes siguen diciendo.
Paso 3: darle un ritmo circadiano
Aquí viene lo contraintuitivo: casi nada de esto corre en tiempo real, y eso es una ventaja.
Cada noche, el ciclo de sueño genera embeddings de los episodios del día para búsqueda semántica, con tope de 100 por noche. Cada lunes lee los últimos siete días de cada clínica (solo clínicas con cinco o más episodios, máximo veinte clínicas por corrida) y destila hasta cinco patrones por cada una: preguntas recurrentes, quejas, huecos que la base de conocimiento de la clínica no sabe responder. Cada mes, decae: cualquier recuerdo no confirmado en treinta días pierde 0,05 de confianza.
El diseño del decaimiento es mi detalle favorito de todo el sistema. Los recuerdos que decaen caen hacia un piso de 0,30, y el umbral de recuperación está en 0,40. No se borran; quedan dormidos, por debajo de la línea donde el agente puede verlos. Si el paciente vuelve a mencionar esa preferencia, el refuerzo despierta la semilla en vez de aprender el hecho desde cero. Olvidar no es destruir. Es degradar.
Y el ritmo por lotes es lo que hace que la economía funcione. El barrido nocturno procesa como máximo 200 conversaciones, la cola corre con concurrencia de 2 para no atropellar mi base de datos, y la matemática de consolidación es SQL plano que no cuesta nada. Un cerebro no tiene por qué ser caro. El mío sueña por centavos.
Paso 4: construir los frenos antes que el músculo
Esto es salud, así que construí los límites primero, y te diría que hagas lo mismo en cualquier dominio.
La regla de alcance: cuando el agente busca episodios pasados, el SQL filtra duro por el teléfono de ese paciente y esa clínica. El modelo nunca decide de quién lee recuerdos, porque los límites de confianza no viven en el prompt.
La regla de datos: el prompt de extracción rechaza información clínica de plano. Sin diagnósticos, sin síntomas, sin motivo de la consulta. Cualquier secuencia de seis o más dígitos se enmascara antes de guardarse, para que números de documento y de teléfono no se filtren en los valores de memoria. En Latinoamérica, donde la cédula y el celular son la llave de casi todo, esa regla no es opcional.
La regla de humildad: todo lo que la memoria aporta a una conversación es consultivo. El paquete de contexto que se inyecta al agente tiene como máximo ocho recuerdos y un resumen pasado, presupuestado en unos 600 tokens, y trae su propio texto de reglas: nunca recitar recuerdos textualmente, nunca usar la memoria como fuente de precios o disponibilidad, y si el paciente contradice un recuerdo, gana el paciente. Los precios y las citas salen de herramientas o no salen.
También hay un interruptor de emergencia. Una variable de entorno apaga toda la capa. Cuando le atornillas memoria a un sistema del que depende gente, quieres el botón de apagado antes que la funcionalidad.
Lo que todavía falta
Los patrones semanales se acumulan como candidatos en una tabla, esperando una cola de aprobación que no he construido. Hoy nadie los revisa, lo que significa que la salida más interesante del ciclo de sueño tiene una audiencia de cero.
Los recuerdos de paciente se recuperan por recencia y confianza, no por significado. Los episodios tienen embeddings; los hechos destilados todavía no. Y en las primeras noches después del lanzamiento, el atraso en embeddings hizo que la búsqueda semántica se degradara en silencio a “los tres más recientes”, y ningún usuario lo notó, lo cual te dice cuánto de esta capa es apuesta y cuánto está probado.
También lancé la fase 1 y la fase 2 el mismo día, con unas dos horas de diferencia. Te lo cuento para que no romantices el proceso: esto no fue un programa de investigación. Fue un lunes.
La primera vez que construí una capa así fue para el copilot de VTEX, con merchants enterprise en vez de pacientes, y esa historia está en lo que costó construir el copilot de VTEX. La segunda vez, esta, tomó un día porque la primera tomó meses.
Tu producto ya lleva un diario
La parte incómoda de todo este proyecto fue darme cuenta de que los datos siempre estuvieron ahí. Diez años de gente contándole a mi sistema quién es, un mensaje a la vez, y el sistema asintiendo y escribiéndolo en una tabla que nunca volvería a abrir.
Tu producto también lleva años escribiendo un diario. El paso 1 es decidir qué es una entrada. Eso lo puedes hacer esta semana.
El mío empieza a soñar a las 2:30. El tuyo todavía solo está dormido.
Ya construí esta capa dos veces en producción, y la segunda vez está en por qué tu producto sigue siendo software. Si tu producto está sentado sobre años de historial que nunca vuelve a leer, quiero saber qué hay en el diario. Me encuentras en LinkedIn o en GitHub.
Posts relacionados
Your AI Coding Agent Has Amnesia. Here's the Fix.
Every new session with Claude Code, Cursor, or Windsurf starts from zero. Agent OS fixes this by capturing your team's conventions as injectable context.
El chatbot comprado duró una semana en VTEX. Esto costó construir el copilot de verdad.
Un chatbot de terceros no aguantó a los merchants enterprise de VTEX. Lo que hizo falta: RAG propio, ruteo por complejidad, memoria y un pipeline de docs.