El chatbot comprado duró una semana en VTEX. Esto costó construir el copilot de verdad.
Un chatbot de terceros no aguantó a los merchants enterprise de VTEX. Lo que hizo falta: RAG propio, ruteo por complejidad, memoria y un pipeline de docs.
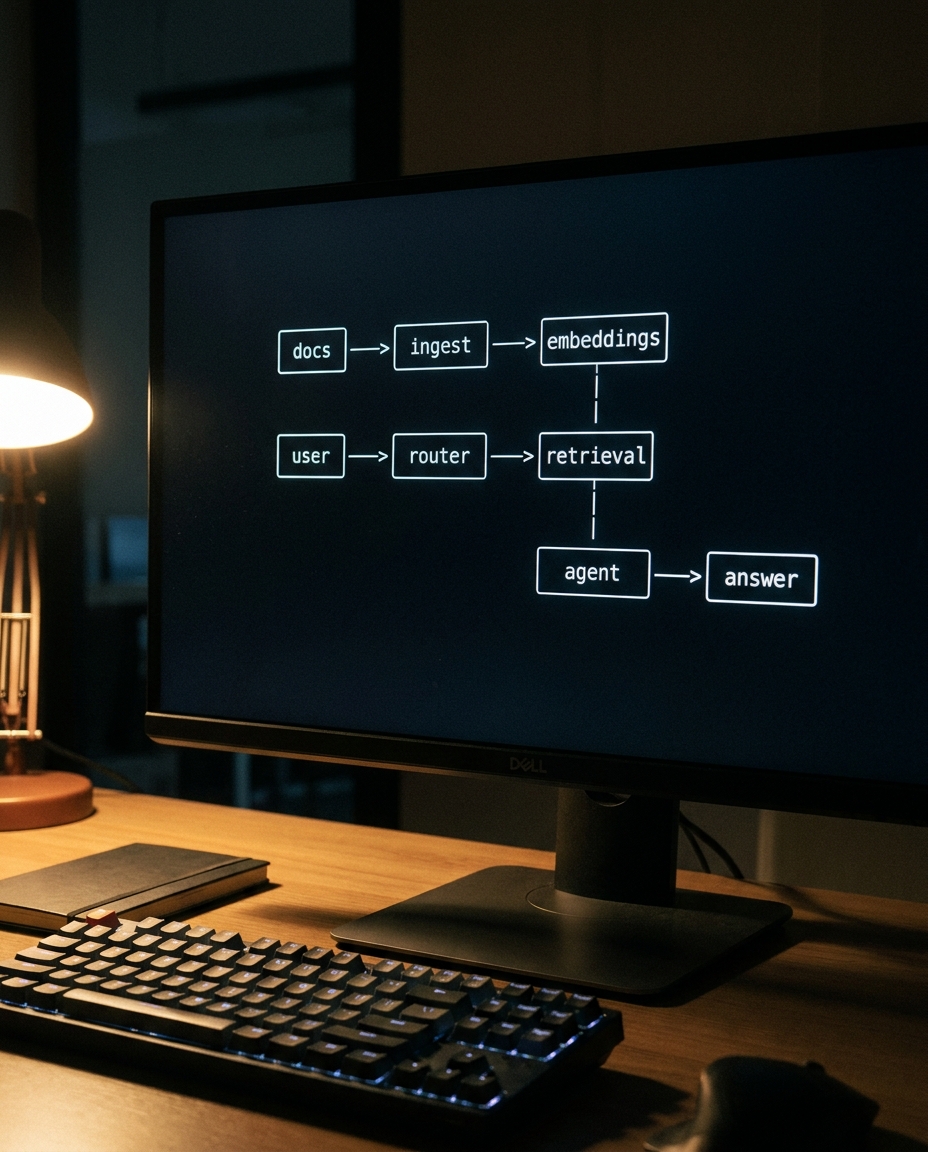
Una semana. Eso duró el chatbot comprado.
Imagina que diriges tecnología en una plataforma de e-commerce con clientes en Brasil, México y Colombia. Alguien propone “ponerle un chatbot” al producto. Suena barato. Suena rápido. Dos semanas después está en producción, conectado a la documentación, respondiendo preguntas.
A la semana un merchant escribe: “Mis clientes internacionales ven la moneda equivocada en el checkout.” El chatbot responde que vaya a Admin, Configuración de tienda, Moneda, y cambie la moneda por defecto.
El merchant sabía que ese no era el problema. El chatbot no. Vio la palabra “moneda” y devolvió el primer documento que la contenía. El problema real era de ruteo de políticas comerciales, configuración de pasarela de pago y reglas de geolocalización. Nada de eso estaba en la respuesta.
Eso no es un problema de chatbot. Es un problema de contexto. Y ese fue el punto en el que el equipo de copilot de VTEX, del que hice parte a finales de 2024, decidió que había que construir el sistema desde cero.
Esta es la versión para quien está a punto de tomar la misma decisión de compra. La versión larga, con más detalle de arquitectura, está en inglés en cómo construimos el copilot de VTEX con RAG y multiagente.
Por qué un cliente enterprise rompe cualquier chatbot genérico
VTEX es una plataforma enterprise que cotiza en bolsa. No es una app de consumo donde todos los usuarios hacen más o menos lo mismo. Cada cliente B2B es un mundo:
- Un retailer de moda en Brasil usa la plataforma de forma completamente distinta a un distribuidor de electrónica en México.
- Un merchant con 50 SKUs no necesita lo mismo que uno con 500.000.
- Algunos operan todo el negocio dentro de la plataforma; otros la usan como una pieza más de un stack complejo.
No existe el “usuario típico”. Cada pregunta trae contexto distinto, expectativas distintas, niveles distintos de conocimiento de la plataforma. Un asistente que responde en genérico no sirve para nada aquí, y el merchant se da cuenta en el primer mensaje.
El patrón
Las soluciones de chatbot listas para usar están diseñadas para soporte simple y clientes pequeños o medianos. No hacen razonamiento en varios pasos, no acceden al contexto de cada cliente y dan la misma respuesta superficial sin importar quién pregunte. Los merchants enterprise lo notaron de inmediato.
Las dos semanas más rentables del proyecto
Sería fácil contar el experimento con el chatbot de terceros como un fracaso. Fue lo contrario: fueron las dos semanas que más valor dejaron. Al ver exactamente cómo fallaba, la especificación de la versión real se escribió sola:
- Ingerir documentación masiva. Miles de páginas de docs, APIs y guías, en varios idiomas. El sistema tenía que consumirlo todo.
- Distinguir niveles de complejidad. Una pregunta simple merece una respuesta rápida y barata. Una pregunta compleja merece razonamiento profundo con un modelo más capaz.
- Memoria persistente. Los merchants no hacen una pregunta y se van. Tienen conversaciones. El sistema tenía que recordar el contexto entre mensajes.
- Ejecutar herramientas. No solo responder, sino hacer cosas en la plataforma.
Si estás evaluando un chatbot para tu producto, esa lista es la prueba. Si el proveedor no puede mostrarte cómo resuelve cada punto con tus datos, vas a repetir nuestra primera semana.
Lo que se construyó en su lugar
El criterio para elegir herramientas fue uno solo: qué nos deja lanzar más rápido sin amarrarnos.
- Orquestación de agentes. Flujos con estado, basados en grafos, capaces del razonamiento en varios pasos que el chatbot comprado no podía hacer. Fue la columna vertebral del sistema.
- Vector store administrado. Rápido, gestionado, una cosa menos que operar.
- Varios proveedores de LLM. No nos casamos con uno. Cada consulta va al modelo que mejor encaja con su complejidad, y si un proveedor se cae el sistema se degrada con gracia en vez de apagarse.
- Reranking. La mejora individual más grande en calidad de recuperación. La búsqueda vectorial te deja en el barrio correcto. El reranking te lleva a la casa correcta.
                     Consulta del usuario
                             │
                             ▼
                    ┌─────────────────┐
                    │  Clasificación   │
                    │  de intención    │
                    └────────┬────────┘
                             │
              ┌──────────────┼──────────────┐
              ▼              ▼              ▼
         ┌─────────┐  ┌──────────┐  ┌──────────┐
         │ SIMPLE   │  │ MEDIA    │  │ COMPLEJA │
         │ LLM      │  │ LLM      │  │ LLM      │
         │ rápido   │  │ medio    │  │ frontera │
         │ 1 pasada │  │ Varias   │  │ Agente + │
         │ <1s      │  │ fuentes  │  │ tools    │
         └────┬─────┘  └────┬─────┘  └────┬─────┘
              │              │              │
              │         ┌────┴─────┐  ┌────┴─────┐
              │         │Retrieval │  │Retrieval │
              │         │+ Rerank  │  │+ Rerank  │
              │         └────┬─────┘  │+ Memoria │
              │              │        └────┬─────┘
              ▼              ▼             ▼
         ┌────────────────────────────────────┐
         │       Ensamblaje de contexto        │
         │  (docs + metadatos + conversación)  │
         └──────────────────┬─────────────────┘
                            │
                            ▼
                        Respuesta
El pipeline de documentación es el producto
Este fue uno de los problemas más duros y del que nadie habla en las demos.
La documentación enterprise es enorme: referencias de API, guías para merchants, docs para desarrolladores, notas de versión, artículos del centro de ayuda, en varios idiomas. Nada de eso estaba estructurado de forma amigable para RAG.
Construimos un pipeline que normaliza todo a un estándar interno: rastrear las fuentes, limpiar el ruido de formato, partir en fragmentos que respetan los límites del documento (secciones con sentido propio, no ventanas fijas de 512 tokens), enriquecer cada fragmento con tipo de documento, área de producto, idioma y fecha de actualización, y por último generar embeddings e indexar.
Pasamos más tiempo en este pipeline que en la capa del LLM. Si tus fragmentos son malos, ningún prompt te salva.
Las cifras publicadas por Cohere y Pinecone apuntan a lo mismo: el chunking semántico combinado con reranking sube la tasa de acierto en recuperación desde el rango del 58% a más del 90%. Nuestra experiencia confirmó la dirección: el salto de calidad al arreglar la ingesta fue mayor que el de cualquier cambio de modelo.
La lección del chunking
Partir en trozos de tamaño fijo es el default de todos los tutoriales. También es incorrecto para la mayoría de casos reales. La documentación tiene límites naturales: títulos, secciones, bloques de código. Respetarlos mejora la relevancia de forma drástica.
Enrutar por complejidad: el costo y la latencia
No toda pregunta merece una llamada a un modelo de frontera. Construimos una capa que clasifica cada consulta y la manda al modelo adecuado:
- Simple: “¿Cuál es el endpoint de búsqueda de productos?” Modelo pequeño, una sola pasada de recuperación, respuesta en menos de un segundo, costo de fracciones de centavo.
- Media: “¿Cómo configuro la importación de catálogo?” Modelo intermedio, recuperación desde varias fuentes, guía paso a paso.
- Compleja: “¿Por qué cayó la conversión del checkout después del último despliegue?” Agente completo con el modelo más capaz disponible, acceso a herramientas, varias pasadas de recuperación.
Los datos de la industria hablan de recortes del 30% al 40% en el costo promedio por consulta cuando más del 90% del tráfico va a modelos ligeros sin perder calidad. Pero el argumento para nosotros fue la latencia: nadie quiere esperar ocho segundos por la URL de un endpoint.
Memoria que sobrevive a quince mensajes
La memoria conversacional suena simple hasta que la construyes para producción.
Los merchants sostienen conversaciones de decenas de mensajes. Hacen referencia a algo que dijeron quince mensajes atrás. Cambian de tema y vuelven. Meter los últimos N mensajes en el contexto choca rápido con el límite de tokens y diluye la relevancia.
Lo que funcionó: memoria estructurada que separa lo que el usuario intenta hacer del historial crudo. El sistema mantiene un resumen vivo de la tarea actual, las entidades clave mencionadas y las preguntas abiertas, independiente del log de mensajes. Ese patrón se me quedó grabado. Años después fue la semilla de el ciclo de sueño que le construí a mi propio producto, y es la razón por la que hoy le digo a cualquier cliente que la memoria del agente es la capa que decide si el sistema sirve.
Operarlo en producción cuesta más que construirlo
Construir el sistema fue la parte divertida. Operarlo fue la parte difícil.
Un pipeline RAG sin optimizar tarda entre 6 y 10 segundos de punta a punta. El desglose aproximado: embedding unos 200 ms, búsqueda vectorial unos 50 ms, reranking unos 150 ms, generación del LLM entre 4 y 8 segundos. Cuando el copilot está metido en un flujo de soporte, “casi siempre es rápido” no alcanza. Hay que pelear cada milisegundo.
Un dato contraintuitivo: el reranking añade unos 150 ms a la recuperación pero reduce el tiempo total de respuesta. Al mandar menos fragmentos y más relevantes al LLM, la generación se acorta bastante. El neto es más rápido, no más lento.
Y así se ve “algo salió mal” en un sistema de IA:
- La API de embeddings tiene un pico de latencia, la recuperación tarda el doble y se rompe el SLA.
- Una actualización de documentación introduce contenido contradictorio y el modelo responde mal con total confianza.
- Un usuario encuentra la forma de hacer que el sistema dé vueltas y el costo en tokens de una sola conversación se dispara.
Cada uno de esos modos de falla exigió monitoreo, alertas y estrategias de respaldo que construimos a medida que los íbamos pisando en producción.
Lo que no quedó resuelto
Sería deshonesto cerrar como si el sistema hubiera quedado perfecto.
- La evaluación nunca tuvo una sola métrica. Medimos calidad de recuperación contra conjuntos curados a mano, calidad de respuesta con un LLM como juez y revisión humana por muestreo, y resolución de la tarea del usuario. Ninguna de las tres cuenta la historia completa por sí sola, y la tercera, que es la que importa, es la más difícil de medir.
- La tasa de resolución que puedo citar es de la industria, no nuestra. Los benchmarks públicos de soporte con IA van del 30% al 40% el primer mes hasta el 55% al 70% con el sistema maduro. No tengo un panel nuestro que pueda señalar con ese número.
- La documentación contradictoria siguió apareciendo. El pipeline la ingiere; no la arbitra. Ese sigue siendo un problema de personas, no de modelos.
Qué significa esto si estás por comprar un chatbot
El modelo fue la decisión menos importante que tomamos. Cambiamos de modelo varias veces durante el desarrollo y la diferencia de calidad fue marginal comparada con el día que arreglamos el chunking. Si estás gastando el 80% del tiempo eligiendo modelo y el 20% en el pipeline de datos, invierte esos números.
Y el equipo no era de investigadores. Nadie había construido un pipeline RAG antes. Nadie había lanzado un sistema multiagente. Lo que había era la costumbre de no parar hasta que la cosa funciona. Un equipo pequeño de ingenieros de backend sacó a producción un sistema que atiende tráfico enterprise real.
El paso concreto para tu producto no es contratar un chatbot. Es responder tres preguntas antes de firmar nada: qué documentación va a leer, cómo va a saber quién le pregunta, y qué va a recordar de la conversación anterior. Si las respuestas son “toda”, “no sabe” y “nada”, ya sabes cuánto va a durar.
¿Estás evaluando un copilot para tu plataforma o ya tienes uno que responde en genérico? Hablemos de arquitectura. Me encuentras en LinkedIn o en GitHub.
Posts relacionados
Your AI Coding Agent Has Amnesia. Here's the Fix.
Every new session with Claude Code, Cursor, or Windsurf starts from zero. Agent OS fixes this by capturing your team's conventions as injectable context.
107.750 citas agendadas y cero memoria: cómo le enseñé a soñar a un producto de diez años
Cada noche a las 2:30 mi sistema de citas por WhatsApp consolida lo que aprendió y olvida a propósito. Los cuatro pasos para darle memoria a tu producto.